GLM-5.3-FlashX 上线:200 tokens/s
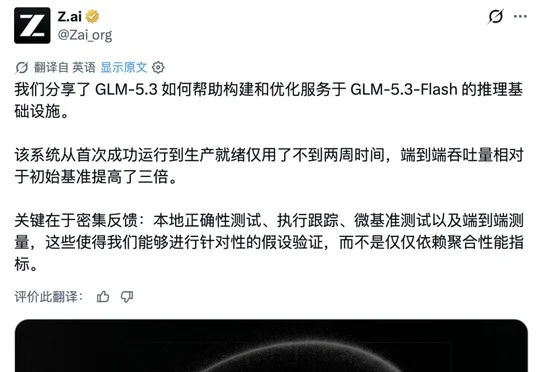
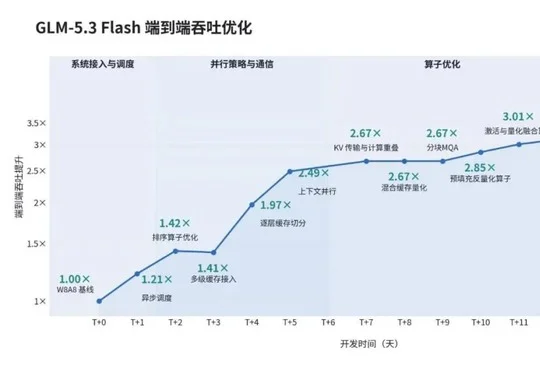
GLM-5.3-FlashX 上线:200 tokens/s智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
搜索
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
智谱首席科学家唐杰发布 GLM-5.3-Flash 推理系统优化成果,模型仅用两周在超 10 万颗国产 AI 加速器集群上完成生产部署,端到端吞吐提升 3.2 倍,并由 GLM-5.3 驱动的 Infra Agent 参与瓶颈分析与代码修改,标志着智谱首个 RSI(递归自我改进)早期形态的落地。
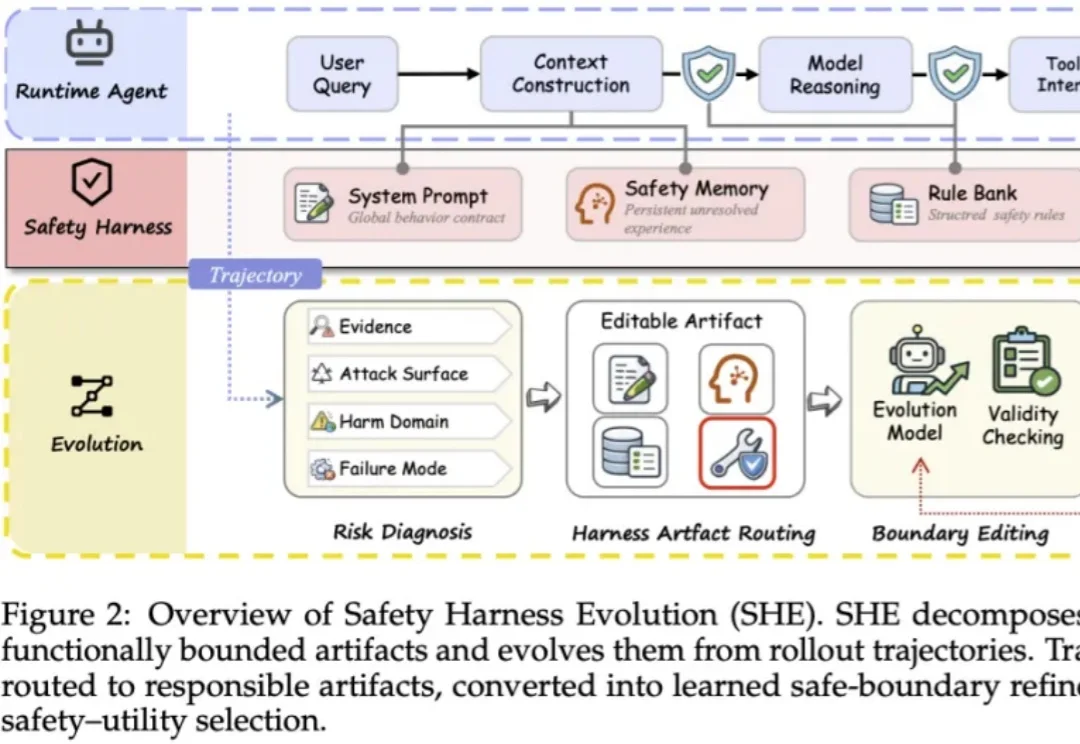
大模型 Agent 进入浏览器、邮件、数据库和业务系统后,安全评估如果仍只检查最终回复是否包含有害内容,覆盖面会明显不足。Agent 需要规划步骤、读取外部信息并调用工具,风险可能出现在执行过程中的任一环节。
当 AI Agent 开始连续数小时替人工作,真正有价值的就不只是最终成果,还有藏在会话(Session)里的整个过程:它做过什么、哪里失败、为何改变方向。
在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
AI Simulation赛道持续升温,Simile估值达20亿美元、由00后创办的Aaru估值近10亿美元、MatrAIx构建83亿虚拟人格,企业通过让AI Agent模拟人类行为来测试产品和预测尚未发生的未来,但这门生意仍面临验证标准、预测精度和规模化等核心难题。
一个 Agent 第一次没把任务做对。
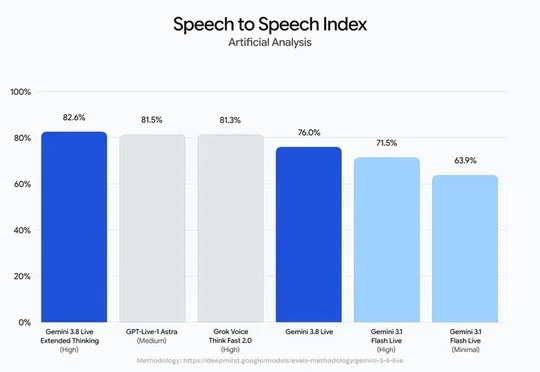
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。